Özet
Çevrimiçi oyun değerlendirme platformlarında kullanıcı puanları; oyunu fiilen deneyimlememiş kullanıcıların koordineli negatif tepkileri (review bombing), karşıt/rakip kitle yönlendirmeleri veya kanıtsız fanatik övgüler (fanboy boosting) nedeniyle ciddi biçimde kutuplaşmaktadır. Bu çalışmada, Metacritic üzerindeki Grand Theft Auto VI (PlayStation 5) sayfasından derlenen 18.537 yazılı kullanıcı incelemesi, yerel donanım (NVIDIA GeForce RTX 4060 Laptop GPU) üzerinde llama.cpp (b12602, Vulkan1) ile çalıştırılan LiquidAI/d1-2B (Q8_0) System One karar modeli aracılığıyla tek ileri geçişte (single forward pass) sınıflandırılmıştır. İncelemeler; oyun deneyimine dair somut kanıt taşıma (has_gameplay_evidence), filtrelenme gerekliliği (should_filter), nitel kategori (reason) ve birebir yinelenen metin kontrolü ölçütleriyle elenmiştir.
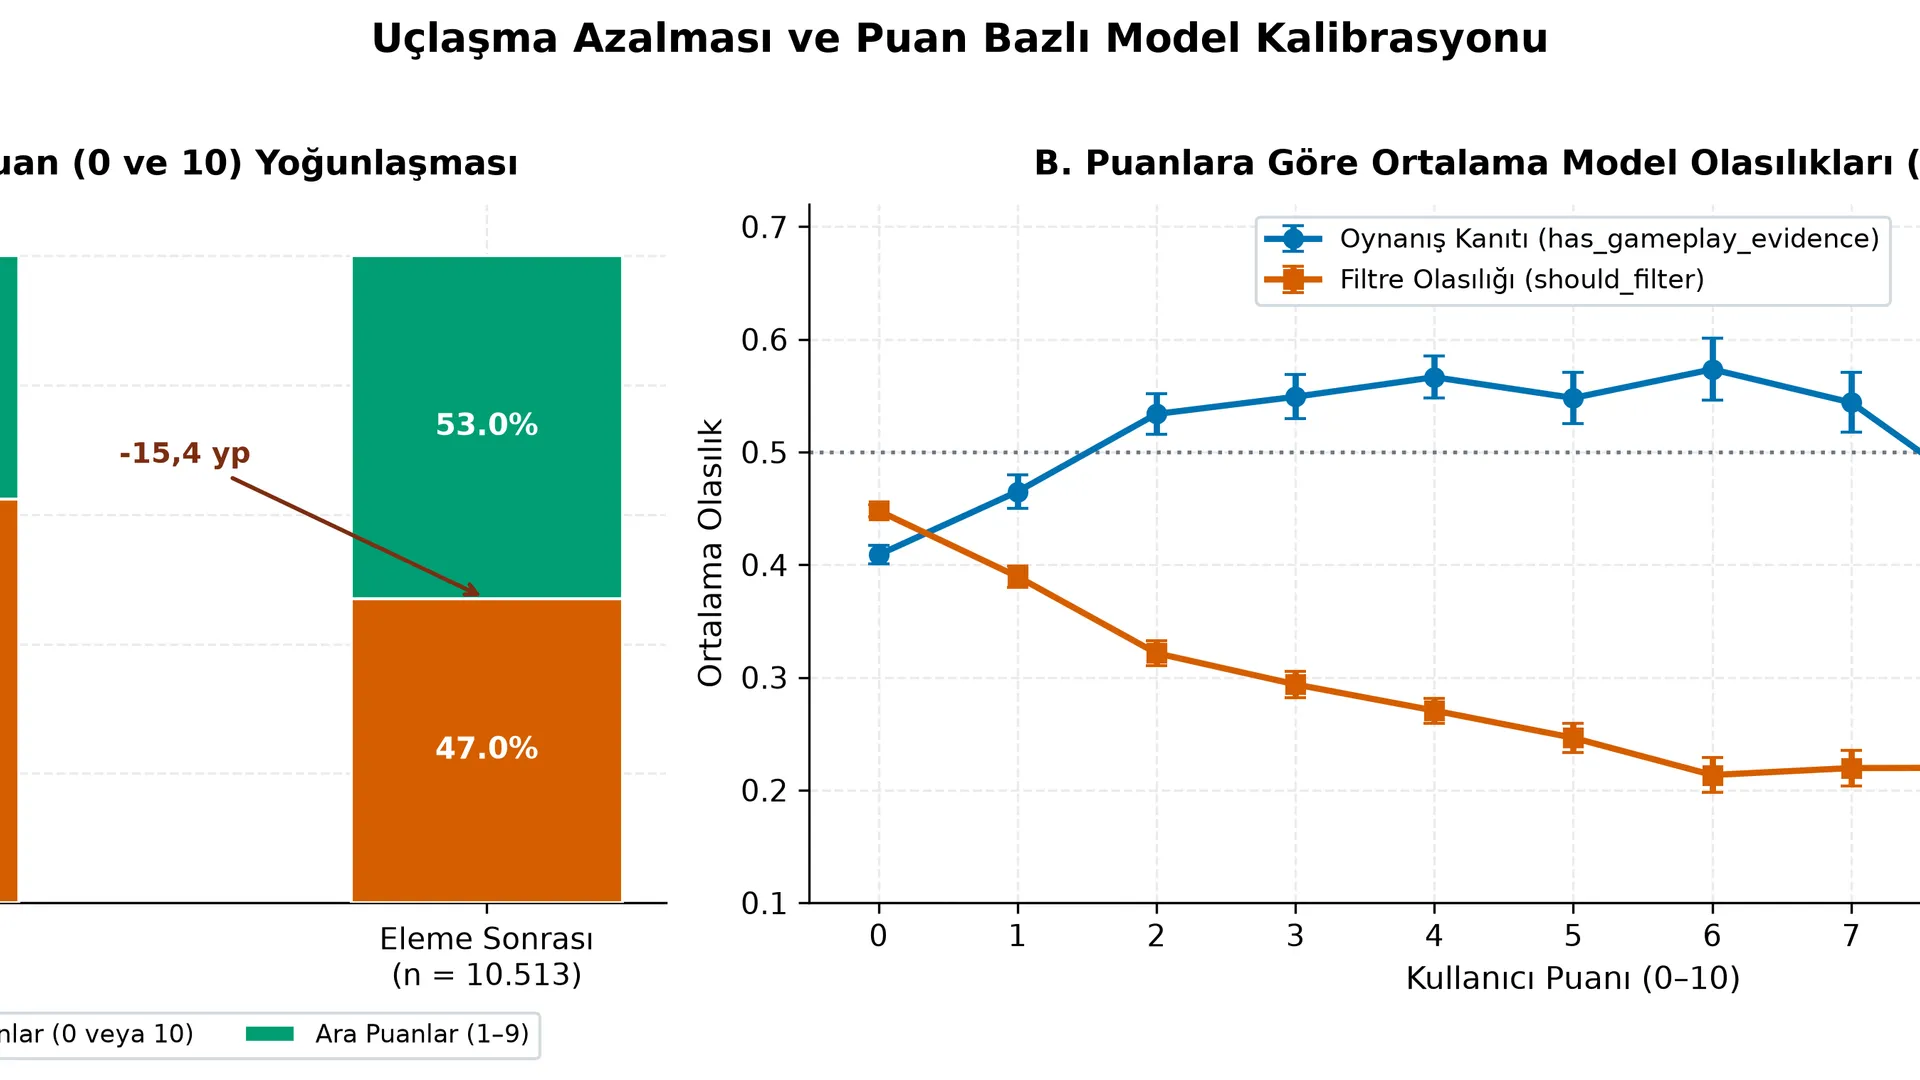
Bulgular, ham veri setindeki 4,7354 ortalama puanın (SD = 4,3088, medyan = 4) eleme sonrasında 4,0271 düzeyine (SD = 3,8441, medyan = 3) düştüğünü göstermektedir (Δ = -0,7083, Welch t = -14,44, p < 0,001, Cohen d = -0,1708). Bu düşüşün temel nedeni, pozitif (8–10) incelemelerin %60,62‘sinin (4.287 / 7.072) oyun deneyimi kanıtı taşımayan tek satırlık övgülerden oluşması nedeniyle elenmesi; buna karşın negatif (0–4) incelemelerin %35,76‘sının (3.581 / 10.014), nötr/karma (5–7) incelemelerin ise yalnızca %10,75‘inin (156 / 1.451) elenmesidir. Eleme sonucunda uç puanların (0 ve 10) toplam içindeki payı %62,39‘dan %46,99‘a gerilemiş, kalan incelemelerin ortalama kelime uzunluğu elenenlere kıyasla 2,24 kat artmıştır (101,63 vs. 45,50 kelime, p < 0,001).
1. Giriş ve Problem Tanımı
Kullanıcı kaynaklı dijital incelemeler, tüketici kararları ve pazar algısı açısından kritik bir sinyal kaynağıdır. Ancak açık erişimli inceleme platformlarında “sahiplik doğrulaması” (verified purchase) bulunmadığında, puan dağılımları gerçek oynanış deneyimini yansıtmaktan uzaklaşabilmektedir. Özellikle yüksek beklentili AAA oyun çıkışlarında iki yönlü gürültü gözlenmektedir:
- Negatif Gürültü (Review Bombing ve Kültür Savaşı Tepkileri): Oyunu oynamadan sıfır puan veren, yalnızca politik/ideolojik tartışmalara, rakip yapımlara veya koordineli kampanyalara dayanan düşük puanlı yorumlar.
- Pozitif Gürültü (Fanboy Hype ve Dengeleme Tepkisi): Oyunun mekanikleri, performansı veya hikâyesi hakkında hiçbir somut gözlem içermeden yalnızca “10/10 başyapıt” veya karşıt kitleye tepki amacıyla atılan yüksek puanlı yorumlar.
Bu çalışma, üretken (autoregressive) metin üretimi yerine kalibre edilmiş olasılıklar döndüren bir System One karar modelinin, büyük ölçekli oyun incelemesi veri setlerinde bu iki tür gürültüyü nasıl ayrıştırdığını ve filtrelemenin topluluk puan ortalaması üzerindeki etkisini nicel olarak incelemektedir.
2. Veri Seti ve Metodoloji
2.1. Veri Seti Özellikleri
Analiz edilen veri, Metacritic üzerinden 21 Kasım 2026 (2026-11-21T08:24:31Z) tarihinde alınan Grand Theft Auto VI (PlayStation 5) kullanıcı incelemelerinden oluşmaktadır:
- Metacritic Genel Özeti (Puan-Only Dahil): Toplam
40.474değerlendirme (19.126pozitif,3.036nötr,18.312negatif), genel platform skoru 5,5/10 (“Mixed or average”). - Yazılı İnceleme Örneklemi: Veride yazılı metin içeren 18.537 benzersiz inceleme bulunmaktadır (geri kalan ~21.937 değerlendirme yazılı metin içermeyen yalnızca sayısal puanlardan oluşmaktadır).
- Tarihsel Dağılım: İncelemeler
2026-11-16ile2026-11-21aralığındadır; toplamın %99,98‘i lansman penceresindeki iki güne (2026-11-20: 8.989,2026-11-21: 9.544) yoğunlaşmaktadır. - Platform: Tüm yazılı incelemeler (
n = 18.537) PlayStation 5 sürümüne aittir. - Duygu Segmentasyonu: Metacritic ölçeğine uygun olarak 0–4 puanlar Negative, 5–7 puanlar Neutral / Mixed, 8–10 puanlar Positive olarak gruplanmıştır.
2.2. Yerel Çıkarım Altyapısı ve Model Konfigürasyonu
Sınıflandırma işlemi harici bir bulut API’si kullanılmadan tamamen yerel ortamda yürütülmüştür:
- Çalıştırma Motoru:
llama.cpp(b12602, Vulkan arka ucu) - Model:
LiquidAI/d1-2B-GGUF:Q8_0(1.92B parametre LFM3-VL-2B tabanlı karar modeli, Q8_0 kuantizasyon) - Donanım: NVIDIA GeForce RTX 4060 Laptop GPU (
Vulkan1, ~3.559 MiB VRAM kullanımı) - Sunucu Parametreleri:
-b 8192 -ub 8192 -dev Vulkan1 -ngl 99(n_slots = 4,/v1/systemoneendpoint’i) - İşlem Hızı: 4 paralel worker ile toplam 18.537 inceleme ortalama ~20,5 inceleme/saniye hızında işlenmiştir.
2.3. Karar Şeması ve Eleme Kuralı
Her bir inceleme (Score: X/10\nReview: <metin[:3500]>) modele tek bir ileri geçişte yöneltilen üç yapılandırılmış soru ile değerlendirilmiştir:
has_gameplay_evidence(noul, P ∈ [0, 1]): İncelemenin mekanik, kontrol, görev, karakter, dünya detayı, performans/bug veya kişisel oynanış deneyimine dair somut kanıt içerip içermediği.should_filter(noul, P ∈ [0, 1]): İncelemenin spam, konu dışı, koordineli bombardıman/şişirme, politik/kültür-savaşı söylemi veya kanıtsız övgü/nefret olarak elenip elenmemesi gerektiği.reason(choice, 4 sınıf):genuine_review,no_play_hate,no_play_hype,spam_offtopic.
Buna ek olarak deterministik ön/son kontroller uygulanmıştır:
- Boş/yalnızca boşluk karakteri içeren metinler
emptyolarak elenmiştir (n = 3). - Küçük harf ve boşluk normalizasyonu sonrası birebir aynı metni tekrarlayan incelemeler (
duplicate_count >= 2)coordinated_duplicateolarak işaretlenip elenmiştir (n = 46). - Nihai eleme kuralı:
(reason != "genuine_review") OR (should_filter >= 0.5) OR empty OR duplicate.
3. Bulgular ve İstatistiksel Analiz
3.1. Eleme Öncesi ve Sonrası Puan İstatistikleri
| Grup | n | Ortalama Puan | Std. Sapma (SD) | Medyan | Çeyrekler (Q₁ – Q₃) | Min – Maks |
|---|---|---|---|---|---|---|
| Eleme Öncesi (Tüm Yazılı İncelemeler) | 18.537 | 4,7354 | 4,3088 | 4 | 0 – 10 | 0 – 10 |
| Eleme Sonrası (Kalan / Temiz) | 10.513 | 4,0271 | 3,8441 | 3 | 0 – 8 | 0 – 10 |
| Elenen Grup (Filtrelenen) | 8.024 | 5,6634 | 4,6919 | 10 | 0 – 10 | 0 – 10 |
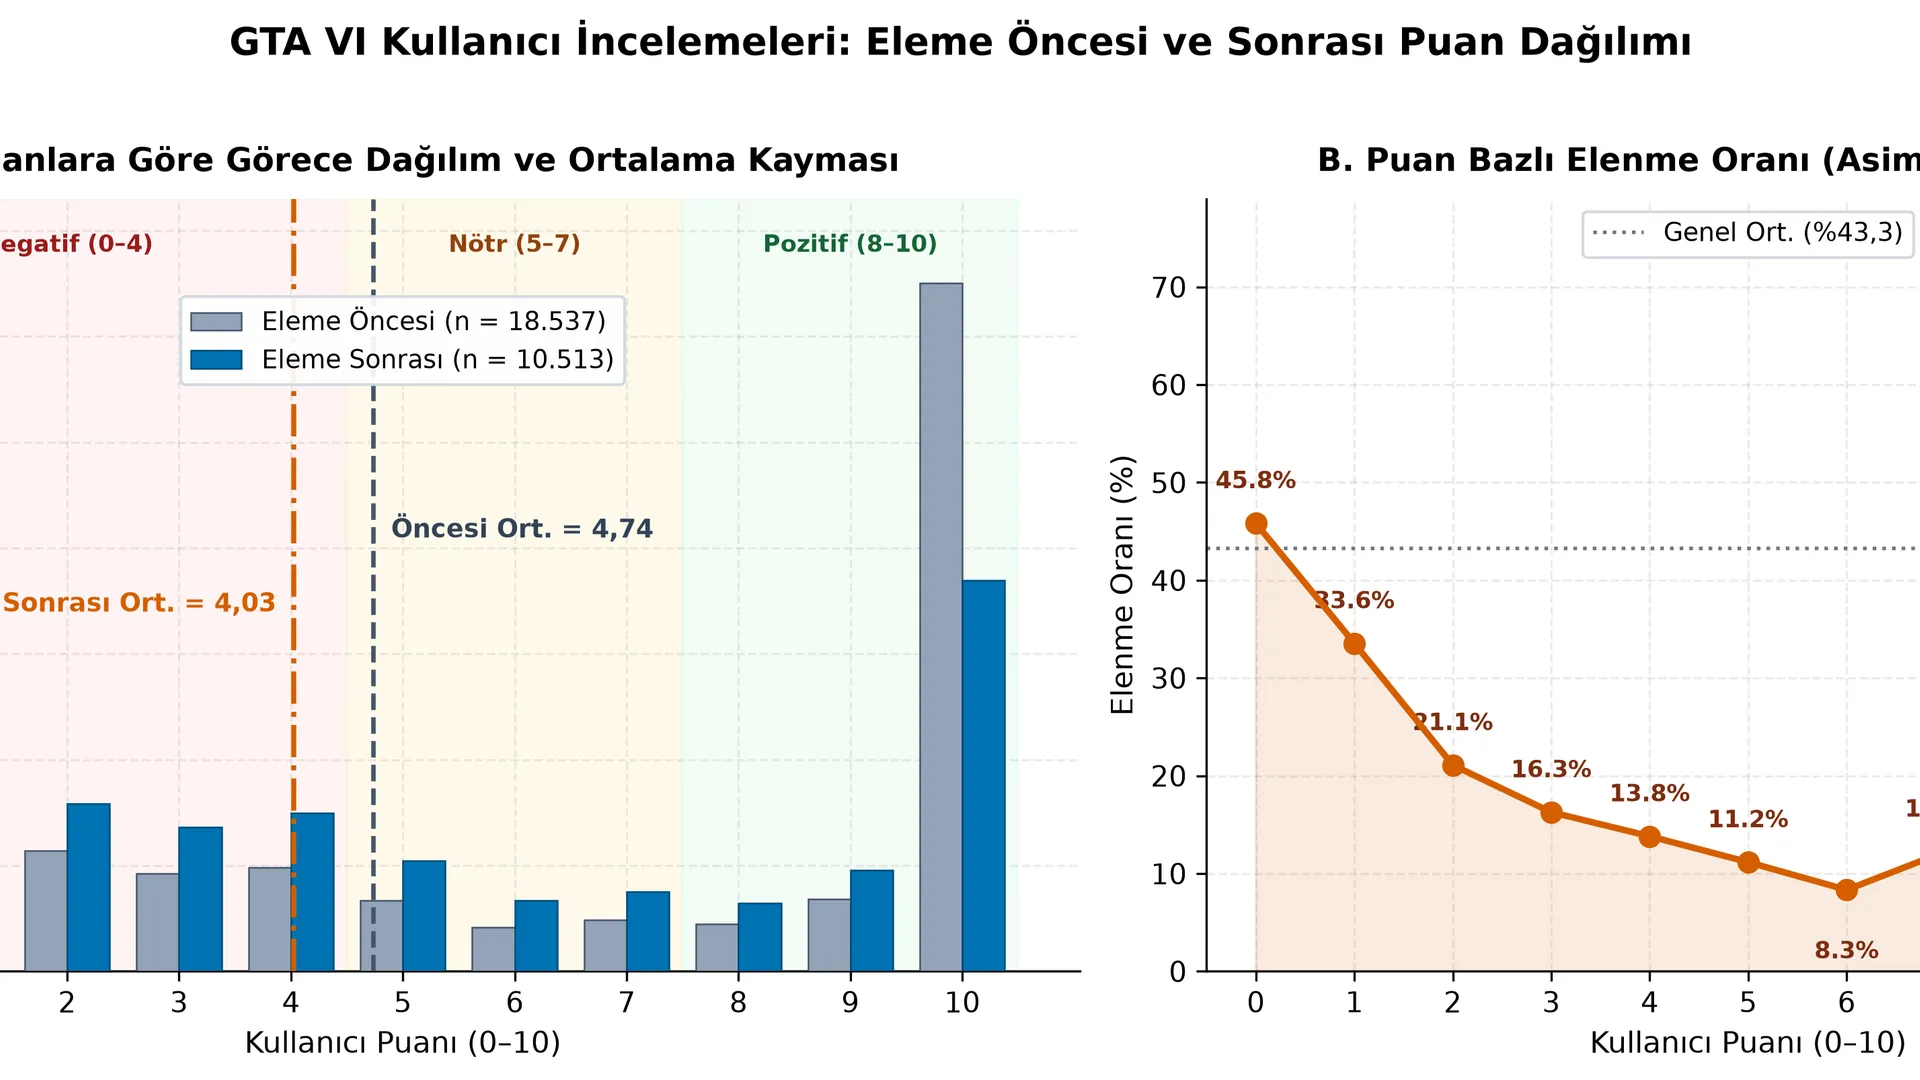
- Puan Kayması (Mean Shift): Eleme sonrasında ortalama puan 0,7083 puan (görece -%14,96) düşmüştür (Welch t = -14,44, df = 23.937,4, p < 0,001, Cohen d = -0,1708).
- Kalan vs. Elenen Ayrımı: Elenen incelemelerin ortalama puanı (5,6634), kalan incelemelerden (4,0271) 1,6363 puan daha yüksektir (Welch t = -25,40, df = 15.287,2, p < 0,001, Cohen d = -0,3866).
- Varyans Daralması: Standart sapmanın 4,3088’den 3,8441’e düşmesi, aşırı uçlardaki gürültünün temizlenmesiyle dağılımın daha dar ve tutarlı bir yapıya kavuştuğunu göstermektedir.
3.2. Duygu Kategorilerine Göre Eleme Oranları
| Duygu Kategorisi (Puan) | Başlangıç (n) | Elenen (n) | Elenme Oranı (%) | Kalan (n) | Kalma Oranı (%) | Pay Değişimi (Önce → Sonra) |
|---|---|---|---|---|---|---|
| Positive (8–10) | 7.072 | 4.287 | %60,62 | 2.785 | %39,38 | %38,15 → %26,49 |
| Negative (0–4) | 10.014 | 3.581 | %35,76 | 6.433 | %64,24 | %54,02 → %61,19 |
| Neutral / Mixed (5–7) | 1.451 | 156 | %10,75 | 1.295 | %89,25 | %7,83 → %12,32 |
| Genel Toplam (0–10) | 18.537 | 8.024 | %43,29 | 10.513 | %56,71 | %100 → %100 |
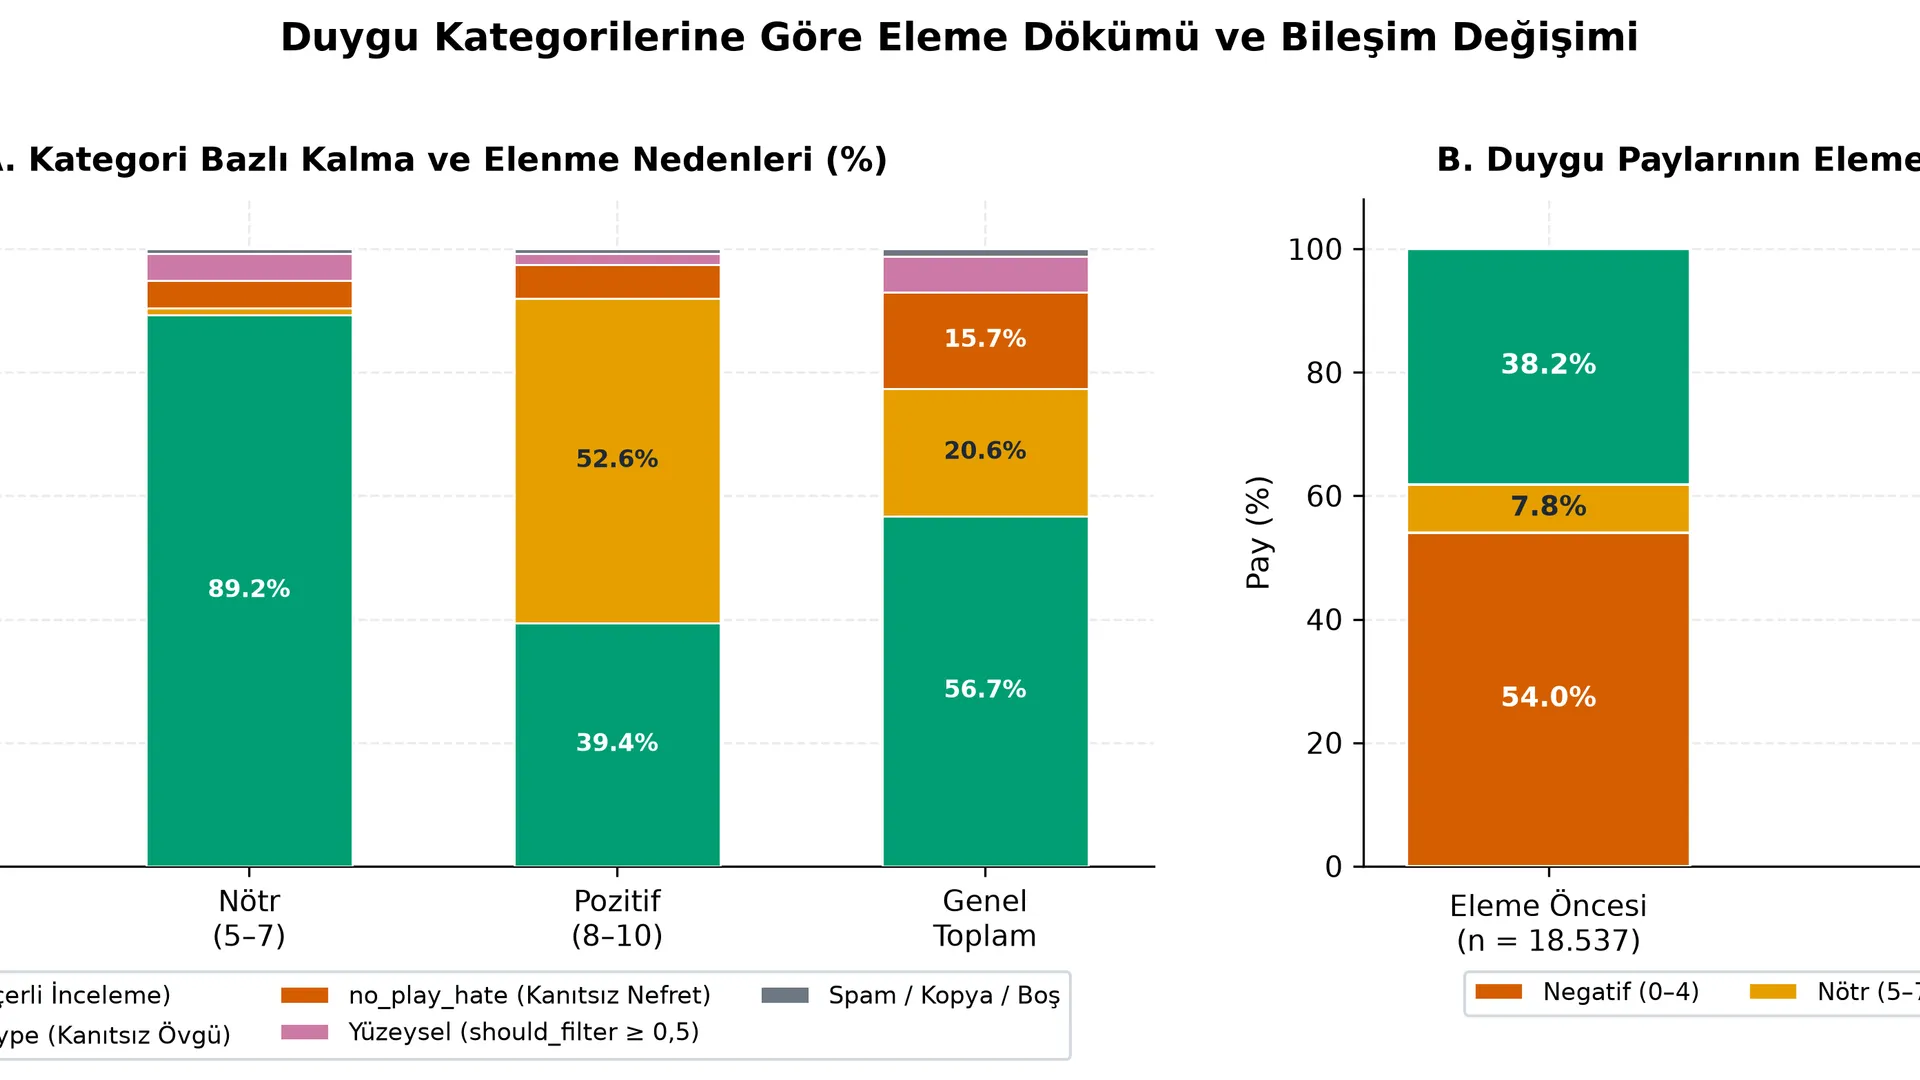
Bu tablo, çalışmanın temel bulgusunu ortaya koymaktadır:
- Pozitif Ağırlıklı Gürültü Asimetrisi: Her ne kadar negatif inceleme sayısı mutlak değerce daha fazla olsa da, pozitif incelemelerin beşte üçünden fazlası (%60,62) oynanış kanıtı taşımayan övgüler nedeniyle elenmiştir.
- Nötr/Karma İncelemelerin Yüksek Güvenilirliği:
5–7puan bandındaki kullanıcılar çoğunlukla oyunun güçlü ve zayıf yönlerini birlikte tartıştığı için %89,25 oranında geçerli kabul edilmiştir. Sonuç olarak, temizlenmiş veri setinde nötr yorumların toplam içindeki payı%7,83‘ten%12,32‘ye yükselmiştir.
3.3. Puan Bazlı (0–10) Detaylı Dağılım ve Kutuplaşma Analizi
| Puan | Eleme Öncesi (n) | Öncesi Pay (%) | Eleme Sonrası (n) | Sonrası Pay (%) | Elenen (n) | Puan İçi Elenme (%) |
|---|---|---|---|---|---|---|
| 0 | 5.537 | %29,87 | 2.999 | %28,53 | 2.538 | %45,84 |
| 1 | 1.654 | %8,92 | 1.099 | %10,45 | 555 | %33,56 |
| 2 | 1.057 | %5,70 | 834 | %7,93 | 223 | %21,10 |
| 3 | 854 | %4,61 | 715 | %6,80 | 139 | %16,28 |
| 4 | 912 | %4,92 | 786 | %7,48 | 126 | %13,82 |
| 5 | 618 | %3,33 | 549 | %5,22 | 69 | %11,17 |
| 6 | 384 | %2,07 | 352 | %3,35 | 32 | %8,33 |
| 7 | 449 | %2,42 | 394 | %3,75 | 55 | %12,25 |
| 8 | 412 | %2,22 | 340 | %3,23 | 72 | %17,48 |
| 9 | 631 | %3,40 | 504 | %4,79 | 127 | %20,13 |
| 10 | 6.029 | %32,52 | 1.941 | %18,46 | 4.088 | %67,81 |
- Uçlaşma Oranı (
0+10Puanlar): Eleme öncesinde incelemelerin %62,39‘u (11.566 / 18.537) yalnızca0veya10puanlarında toplanmaktaydı. Eleme sonrasında bu oran %46,99‘a (4.940 / 10.513) gerilemiştir (-15,40 yüzde puan). - U-Şekilli Gürültü Profili: Puan içi elenme oranları
6/10puanında %8,33 ile minimuma inerken, uçlara gidildikçe parabolik biçimde artmakta ve0/10‘da %45,84‘e,10/10‘da ise %67,81‘e ulaşmaktadır. Bu simetrik olmayan U-eğrisi, karar modelinin uç noktalardaki kanıtsız tepki oylarını hedeflediğini, ara puanlardaki nüanslı incelemeleri ise koruduğunu doğrulamaktadır.
3.4. Elenme Nedenlerinin Dağılımı
| Elenme / Kalma Etiketi | Positive (8–10) | Neutral (5–7) | Negative (0–4) | Genel Toplam |
|---|---|---|---|---|
genuine_review (Kalan) |
2.785 | 1.295 | 6.433 | 10.513 |
genuine_review (ancak should_filter >= 0.5 ile elenen) |
128 | 63 | 873 | 1.064 |
no_play_hype (Kanıtsız övgü / hype) |
3.717 | 16 | 86 | 3.819 |
no_play_hate (Kanıtsız nefret / review bombing) |
386 | 66 | 2.455 | 2.907 |
spam_offtopic (Spam / konu dışı) |
45 | 9 | 131 | 185 |
coordinated_duplicate (Birebir kopya metin) |
10 | 2 | 34 | 46 |
empty (Boş metin) |
1 | 0 | 2 | 3 |
Not: 10/10 puanlı incelemelerin (n = 6.029) 3.638’i no_play_hype ve 307’si no_play_hate (ör. anti-eleştirmenlere yönelik karşı-saldırı metinleri) olarak elenmiştir. 0/10 puanlı incelemelerin (n = 5.537) ise 1.785’i no_play_hate, 574’ü should_filter >= 0.5 eşiğine takılan yüzeysel genuine_review ve 100’ü spam_offtopic olarak ayrılmıştır.
3.5. Metin Uzunluğu ve Model Kalibrasyonu (Yapı Geçerliliği)
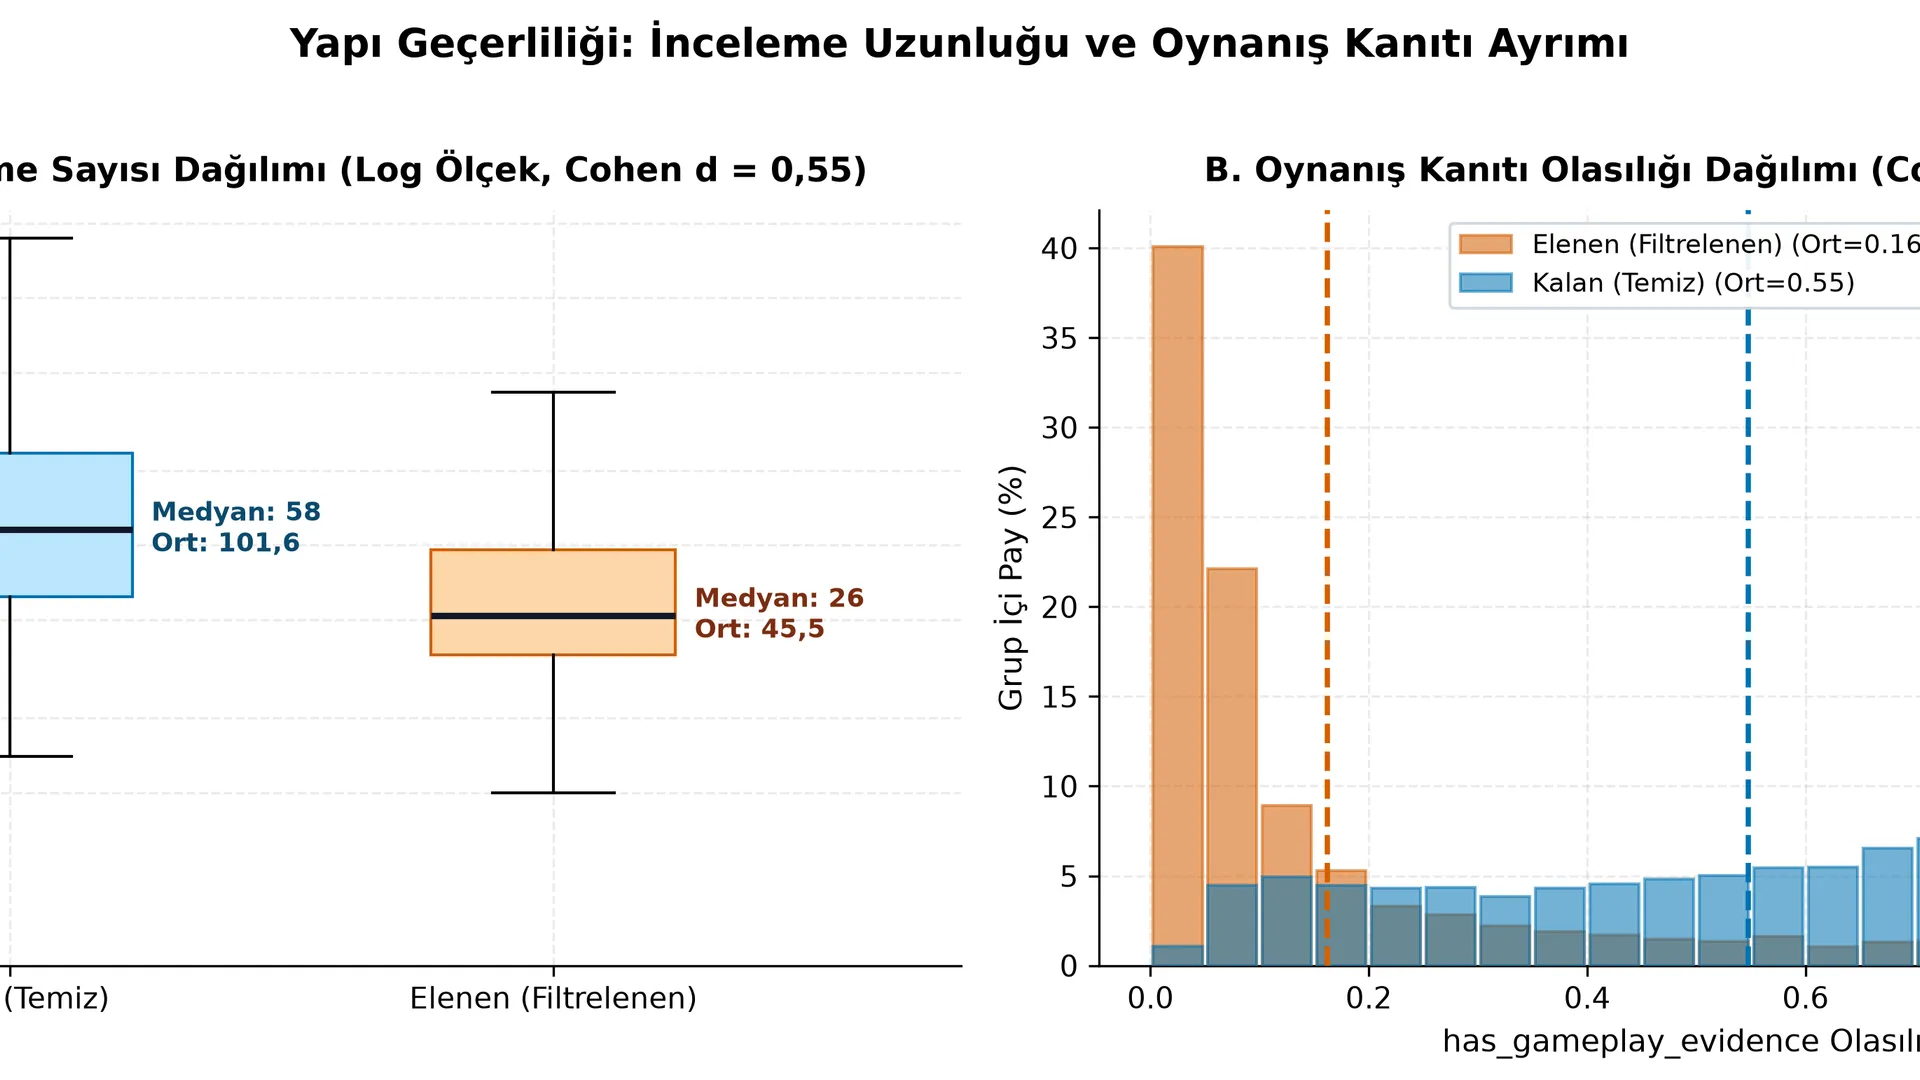
Filtrelemenin yalnızca puanlara değil, metinsel kanıt derinliğine dayandığını doğrulamak amacıyla kelime/karakter uzunlukları ve model olasılıkları incelenmiştir:
| Metrik | Kalan (n = 10.513) Ort. (Medyan) | Elenen (n = 8.024) Ort. (Medyan) | Welch t | Cohen d |
|---|---|---|---|---|
| Karakter Uzunluğu | 573,33 (316) | 256,07 (146) | 38,98 (p < 0,001) | 0,5330 |
| Kelime Sayısı | 101,63 (58) | 45,50 (26) | 40,19 (p < 0,001) | 0,5499 |
has_gameplay_evidence Olasılığı |
0,5477 (0,5857) | 0,1617 (0,0650) | 110,06 (p < 0,001) | 1,5789 |
should_filter Olasılığı |
0,2359 (0,2143) | 0,4990 (0,5364) | -95,68 (p < 0,001) | -1,5314 |
- Karakter uzunluğu ile
has_gameplay_evidenceolasılığı arasında orta düzeyde pozitif korelasyon gözlenmiştir (Pearson r = 0,3841). Korelasyonun 1’e yakın olmaması, modelin uzunluğu tek başına bir gösterge olarak kullanmadığını; uzun ancak konu dışı politik tiradları eleyip kısa ama teknik detay içeren (ör. FPS/kayıt hatası bildiren) yorumları koruyabildiğini göstermektedir.
4. Skor-Kör (Score-Blind) Ablasyon Deneyi ve Sağlamlık Analizi
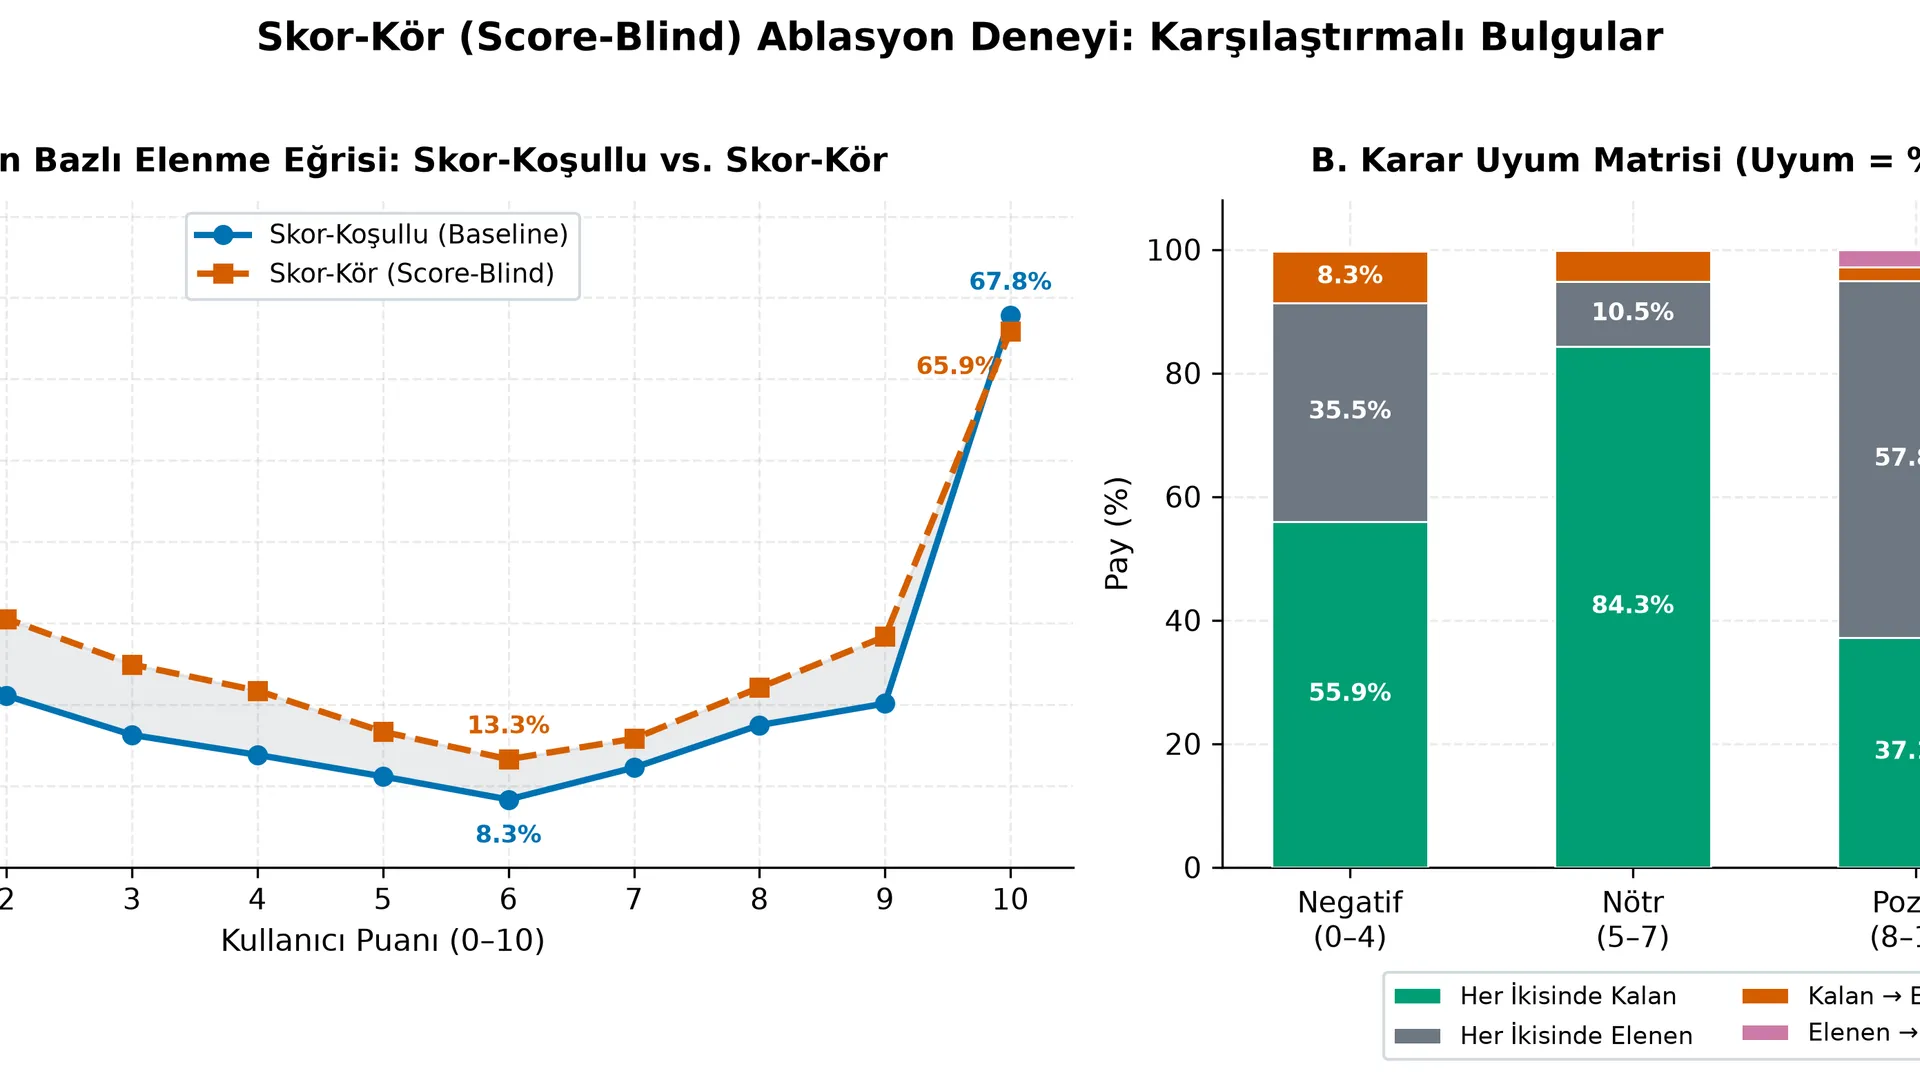
Ana deneyde modele verilen Score: X/10 bilgisinin karar olasılıkları üzerinde bir önyargı (score conditioning prior) oluşturup oluşturmadığını test etmek amacıyla, tüm değişkenlerin sabit tutulduğu ancak girdi metninden puan satırının çıkarıldığı (Review: <metin>) bir skor-kör (score-blind) ablasyon deneyi gerçekleştirilmiştir (n = 18.537).
4.1. Karşılaştırmalı İstatistikler
| Koşul | Kalan (n) | Elenen (n / %) | Ortalama Puan (SD) | Medyan | Pozitif Elenen (%) | Negatif Elenen (%) | Nötr Elenen (%) |
|---|---|---|---|---|---|---|---|
| Eleme Öncesi (Ham) | 18.537 | — | 4,7354 (4,3088) | 4 | — | — | — |
| Skor-Koşullu (Baseline) | 10.513 | 8.024 (%43,29) | 4,0271 (3,8441) | 3 | %60,62 | %35,76 | %10,75 |
| Skor-Kör (Score-Blind) | 9.683 | 8.854 (%47,76) | 4,2940 (3,9171) | 3 | %60,01 | %43,79 | %15,51 |
- Ana Etkinin Korunması: Puan bilgisi gizlendiğinde dahi eleme sonrası ortalama puan ham ortalamaya göre istatistiksel olarak anlamlı biçimde düşmektedir (Δ = -0,4414, Welch t = -8,68, df = 21.336,9, p < 0,001, Cohen d = -0,1056).
- Yüksek Karar ve Olasılık Uyumu: İki koşul arasında ikili kalma/elenme kararında %92,99 (17.237 / 18.537, Cohen κ = 0,8589), 4-sınıflı
reasonetiketinde %92,60 (Cohen κ = 0,8673) uyum elde edilmiştir. Sürekli olasılık çıktıları arasındaki Pearson korelasyonuhas_gameplay_evidenceiçin r = 0,9922 (0,3806 vs. 0,3519),should_filteriçin r = 0,9805 (0,3498 vs. 0,3844) olarak ölçülmüştür.
4.2. Koşullandırma Önyargısının Yönü (Flip Analizi)
Toplam 1.300 incelemede karar değişimi gözlenmiştir (kept_to_filtered = 1.065, filtered_to_kept = 235), bu da skor-kör ortalamayı skor-koşullu ortalamanın +0,2669 puan üzerine çıkarmıştır (Welch t = 4,88, p < 0,001, Cohen d = 0,0688):
- Negatif (
0–4) İncelemelerde Tolerans Farkı: Skor gizlendiğinde, skor-koşullu modelin koruduğu 834 negatif inceleme elenmiş, yalnızca 30 inceleme geri kazanılmıştır (0/10puanında 412 vs. 26). Bu bulgu, modelinScore: 0/10bağlamını gördüğünde kısa şikâyetleri meşru memnuniyetsizlik olarak değerlendirmeye biraz daha yatkın olduğunu göstermektedir. - Pozitif
10/10İncelemelerde Şüphecilik Farkı:10/10puanlı incelemelerde ise ters yönde bir kayma yaşanmış (202 inceleme skor-kör koşulda geri kazanılırken 88 inceleme elenmiştir;8ve9puanlarında geri kazanılan inceleme sayısı 0’dır). ModelScore: 10/10etiketini gördüğünde sınırda kalan övgülerino_play_hypeolarak işaretlemeye hafifçe daha eğilimli olmuştur.
5. Tartışma ve Metodolojik Sınırlılıklar
- Yazılı İnceleme Seçilim Yanlılığı (Selection Bias): Metacritic’in genel
5,5/10ortalamasına kıyasla yazılı incelemelerin eleme öncesi ortalaması4,7354/10çıkmaktadır. Bunun nedeni, yalnızca puan veren (~21.937) kullanıcıların yazılı eleştiri yazanlara göre daha pozitif eğilimli olmasıdır. Dolayısıyla bu çalışma “tüm kullanıcı oylarının” değil, yazılı kullanıcı incelemelerinin gürültü profilini modellemektedir. - Negatif Eleştirilerin Kalıcılığı: Eleme sonrasında puan ortalamasının
4,03–4,29aralığına inmesi, PlayStation 5 lansmanındaki teknik şikâyetlerin (30 FPS kilidi, performans sorunları, hikâye/tempo eleştirileri vb.) büyük kısmının somut oyun deneyimine dayandığını ve gerçekçi/eleştirel metinler içerdiği için filtreyi geçtiğini ortaya koymaktadır. Buna karşılık pozitif cephede kısa “10/10” övgülerinin baskın olması yüksek eleme oranını açıklamaktadır. - Skor Koşullandırması (Score Conditioning) Sınır Değerleri: Bölüm 4’teki ablasyon deneyi,
Score: X/10bilgisinin modele verilmesinin kararları temelden değiştirmediğini (κ = 0,8589, r > 0,98), ancak negatif kısa yorumlarda hafif müsamaha ve10/10yorumlarda hafif şüphecilik yarattığını nicel olarak ortaya koymuştur. Bu nedenle gerçek temizlenmiş puan ortalaması için4,0271(skor-koşullu) ile4,2940(skor-kör) arasındaki aralık güvenilir bir duyarlılık bandı olarak raporlanmalıdır. - Kültür-Savaşı ve Hibrit Yorumlar: Hem karşı-polemik hem de somut oynanış detayı içeren hibrit yorumların bir kısmı
no_play_hateveyano_play_hypesınıfına çekilebilmektedir.
6. Sonuç
Yerel bir System One karar modeli (LiquidAI/d1-2B Q8_0), 18.537 adet kullanıcı incelemesini token üretimine gerek duymadan kalibre edilmiş olasılıklarla sınıflandırmayı başarmıştır. Sonuçlar, oyun değerlendirme platformlarındaki uç puanların (0 ve 10) büyük bir bölümünün (%45,84 ve %67,81) oynanış kanıtı taşımayan tepkisel veya fanatik yorumlardan oluştuğunu; puan bilgisi tamamen gizlendiğinde dahi bu asimetrik gürültü profilinin korunduğunu (κ = 0,8589) ve temizleme sonrasında daha uzun, daha bilgilendirici ve daha az kutuplaşmış bir eleştiri gövdesi elde edildiğini göstermektedir.